一年前,全球AI调用量前十名里只有2个中国模型。现在,占了7个。
🎯 一个数据正在改写AI格局
你可能没注意到,但这个周末AI行业发生了一件意义深远的事——中国大模型,正在用"性价比"重新定义全球竞争规则。
9月17日,国际AI模型API聚合平台 OpenRouter 公布了最新一周的调用量数据:
- 中国大模型周调用量:61.2万亿Token
- 美国大模型周调用量:21.8万亿Token
- 连续第20周,中国超过美国,位居全球第一
而在可见的调用量前十名榜单中,中国模型占据至少7席,合计占比超过70%。
一年前,这个榜单上中国模型的数量还是 2个。一年后,变成了 7个。
这场逆转,是怎么发生的?
📊 01|数据冲击:从"追赶"到"碾压"
让我们先看一组震撼的对比:
| 时间节点中国模型Top份额美国模型Top份额第一名 | |||
| 2025年9月 | 不足20% | 约80%(谷歌39%+OpenAI+xAI) | 谷歌 |
| 2026年9月 | 超过45% | 约43% | GPT-5.6 Luna(OpenAI)/ Hy4 preview(腾讯) |
数据来源:OpenRouter平台统计。厂商份额层面中国整体已超美国,但单模型排名美国GPT-5.6 Luna仍居首,中国模型在数量上占优。
OpenRouter平台每周处理的Token总量,从2025年9月的4.92万亿,增长到今年9月的127万亿——一年增长接近25倍。
在这个开发者可以自由选择模型的开放市场里,中国模型已经成了流量分配的主力。
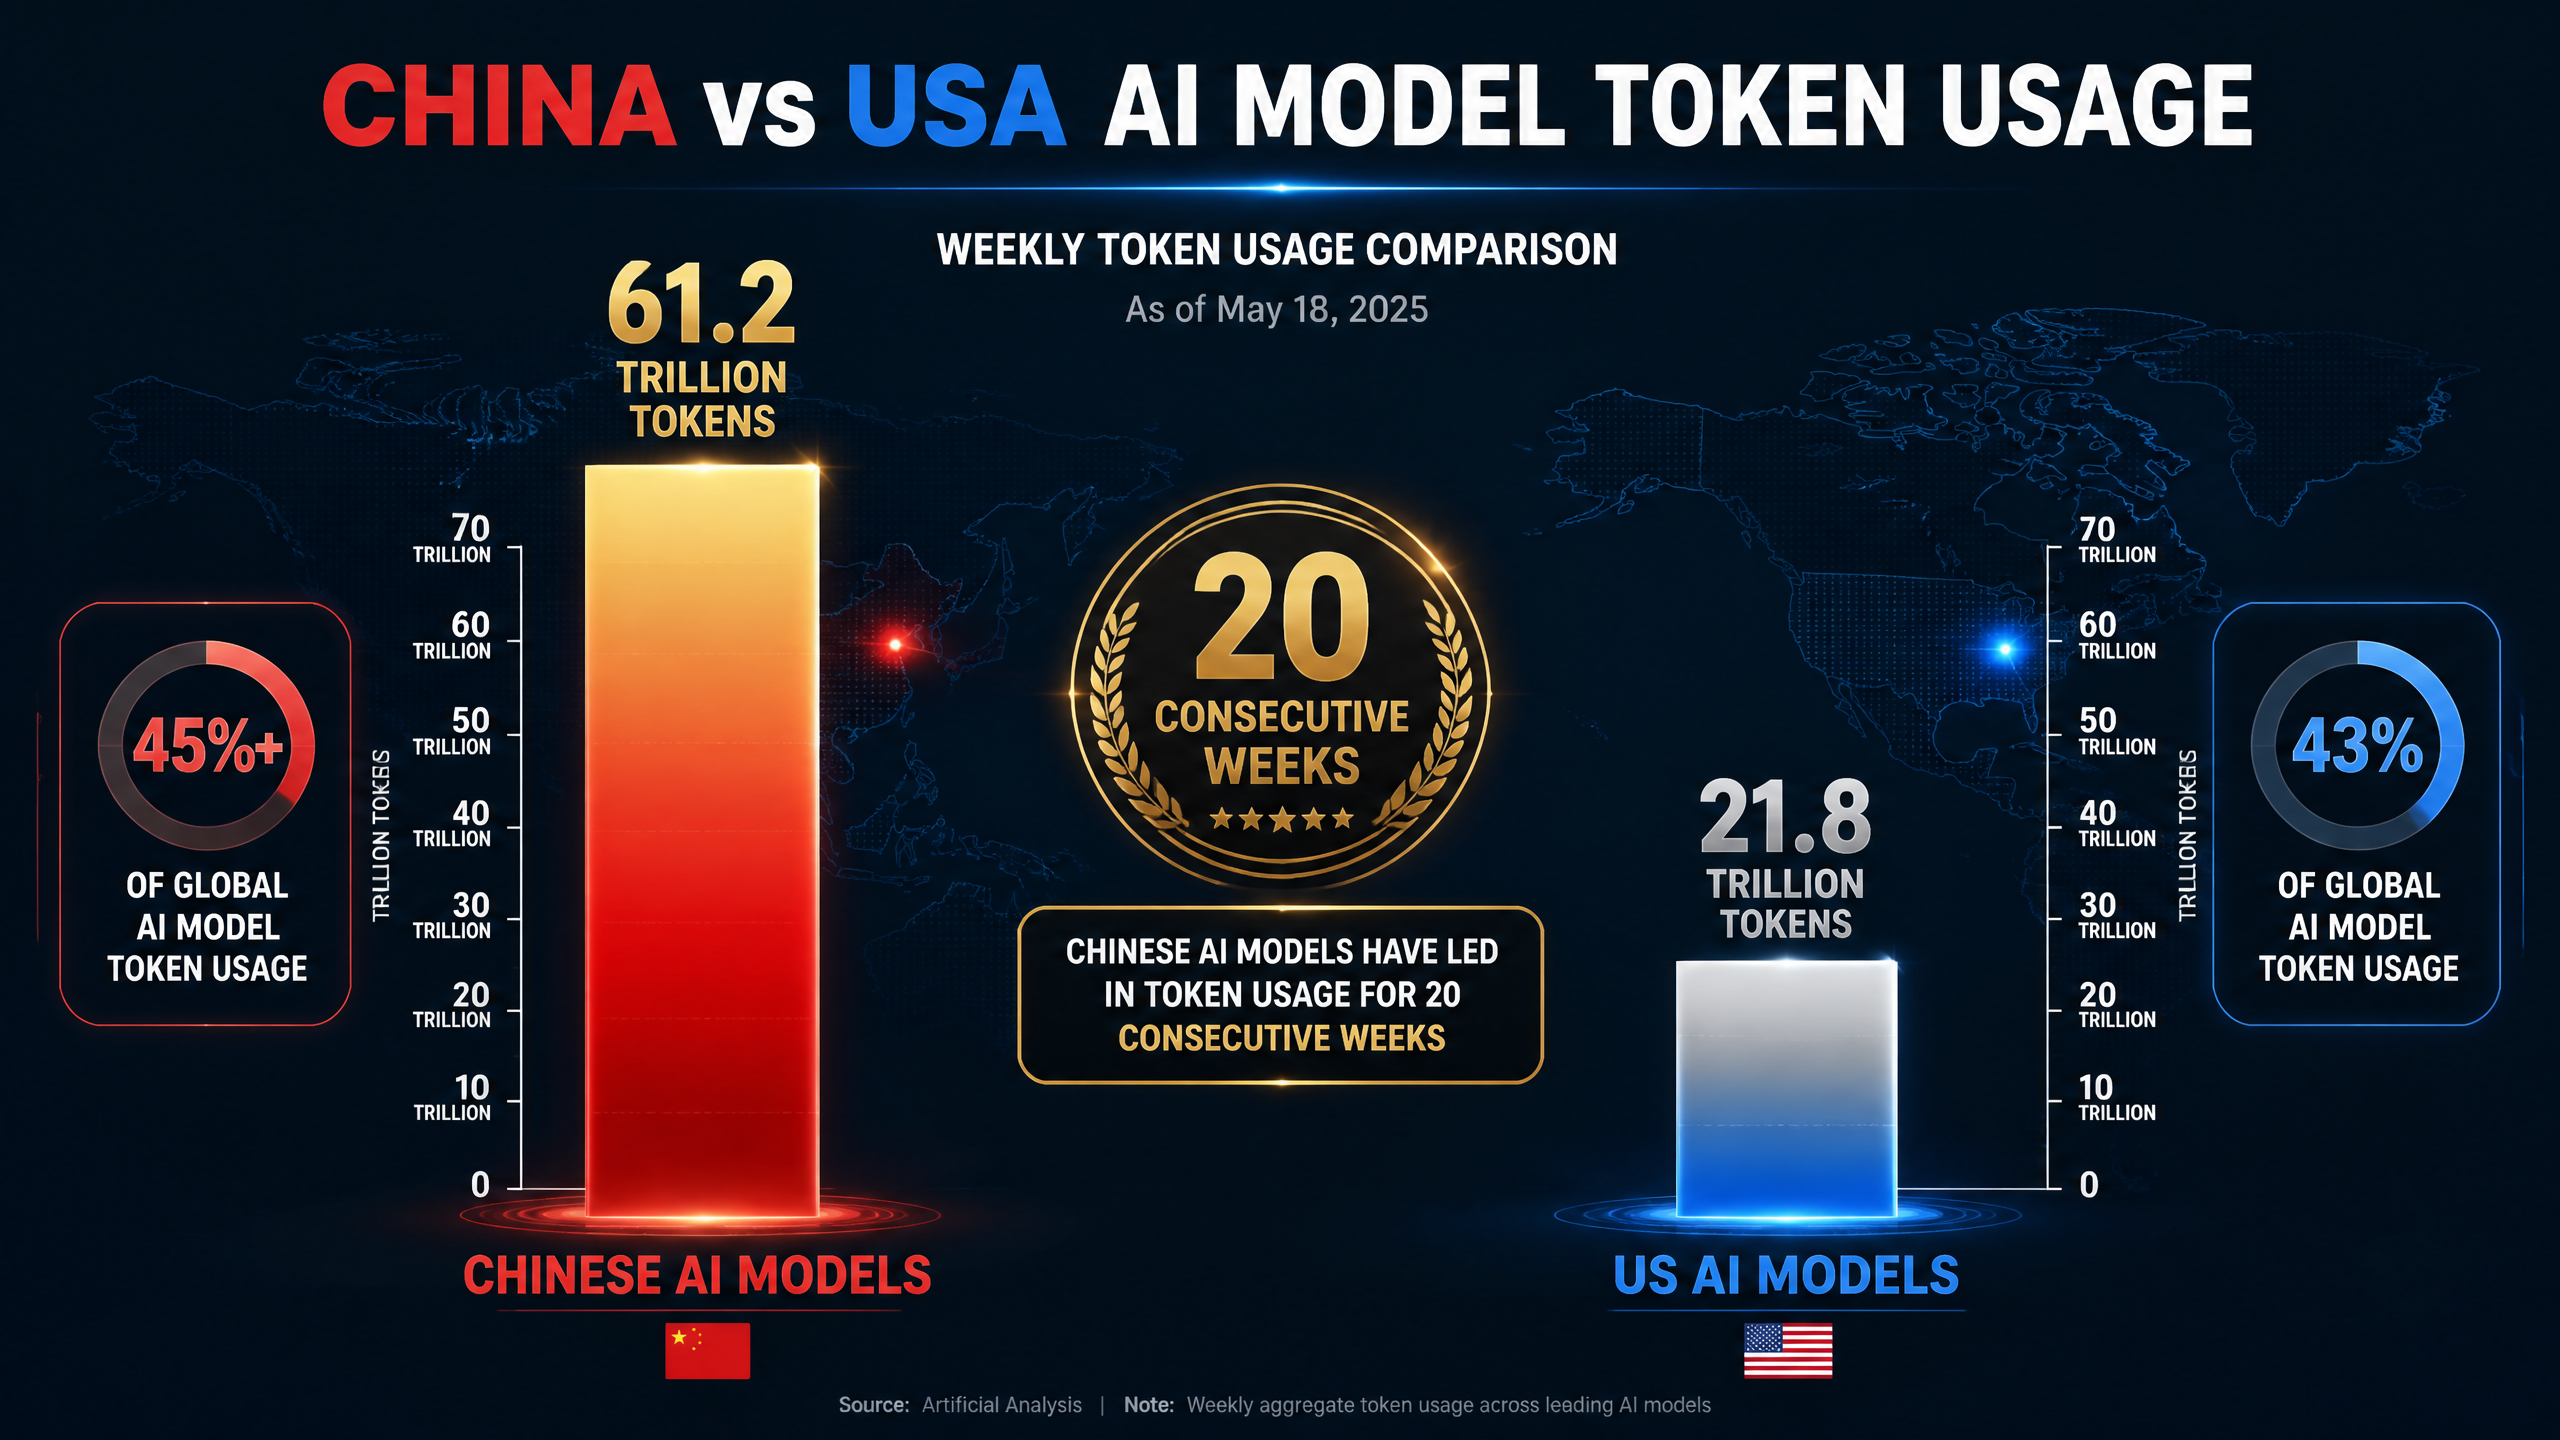
数据来源:OpenRouter平台统计(2026年9月7-13日)
⚡ 02|DeepSeek V4.1 Flash:48小时改写历史
9月10日,DeepSeek正式发布 V4.1 Flash 模型。
发布后的数据堪称惊人:
- 24小时内:处理了约 1万亿Token
- 48小时内:调用量有望达到 2.8万亿Token
- OpenRouter周榜排名:发布不到一周冲到 第6名
一位海外开发者评价道:
"这很有趣,AI领域的用户似乎在几个小时内、而非几天,就将DeepSeek新模型切换到他们的工作流程和应用中。"
这种"小时级迁移"的速度,在全球AI历史上都是罕见的。
为什么这么快?
💰 03|价格屠夫:成本只有美国同行的1/10
答案很简单:便宜,便宜到离谱。
OpenRouter披露,V4.1 Flash约90%的调用量来自缓存读取,按市场定价计算:
每百万Token成本约为 0.006美元
作为对比,相近性能的美国模型(如GLM-5.3 Flash等),成本大约是这个数字的 5-10倍。
经历一轮涨价与降价之后,DeepSeek依然扮演着大模型市场"价格屠夫"的角色。

AI评测机构Arena.ai的数据显示:
- V4.1 Flash在Agent Arena中位列开源模型第三
- 每项任务成本中位数仅为 0.07美元
- 与顶尖模型Fable 5.1相比,成本降低97%-99%
- 却仍保留了对方 35%-54% 的净改进效果
一位海外创业者直言:
"对于初创公司构建智能体工作流来说,超过90%的成本降低是唯一能在不烧光风投资金的情况下实现规模化的方法。 DeepSeek真的抓住了要害。"
🧠 04|能力差距还在,但"够用+便宜"正在赢
当然,我们得承认一个事实:
在纯能力榜单上,中国模型还没有拿到第一名。
根据AI基准测试机构Artificial Analysis的最新数据,智能指数前五名仍然是海外模型:
- Claude Fable 5.1(Anthropic)
- GPT-6 Astra(OpenAI)
- Gemini 3.8 Flash(Google)
- Muse Spark 1.3(Meta)
- ...
排名最高的国产模型 智谱GLM-5.3 位列第7,与第一名相差8分。
但问题是:99%的日常任务,真的需要"第一名"的能力吗?
一位国内开源项目开发者的话很有代表性:
"今年初我还在用Claude作为核心工作流模型,但5月开始就全部切换为国产模型了。99.99%的编程任务对GLM 5.3这一档的模型来说,都称不上是较难的任务。"
Mozilla最新报告也指出:中美大模型的智商差距约为 4.4个月,但正在快速缩小。
当性能差距缩小到"够用",而价格差距扩大到"10倍"时,市场会用脚投票。
🚀 05|对普通人意味什么?AI门槛正在消失
这场"性价比革命"最终指向一个结论:
AI工具,正在变得越来越便宜、越来越好用。
瑞银证券中国互联网分析师观察到,2026年下半年,"Token ROI"(AI投入产出比)正在成为行业关键词。
企业与用户此前的关注点单纯是"能力够不够强",但今年逐渐转向"同样的钱,能不能办更多的事"。
国内主流模型的API定价,大约只有国际同行的 10%-20%。瑞银调研还发现,中国模型厂商的API业务毛利率大多处于 20%-40% 区间——
这不是亏本换市场,而是通过模型架构创新和推理效率优化,实实在在把成本降下来了。
对创业者来说:
- 搭建一个AI应用的算力成本,一年可能下降 80%
- 试错门槛更低,创新速度更快
对普通用户来说:
- 各种AI工具会越来越便宜,甚至免费
- 用AI辅助写作、编程、翻译、分析,成本趋近于零

这场竞争的真正赢家,不是某一家公司,而是每一个使用AI的人。
💬 写在最后
一年前,如果有人告诉我中国大模型的全球调用量会超过美国,我可能会觉得那是遥远的未来。
但仅仅12个月后,这个事实就摆在了面前——而且不是勉强超过,是近3倍的碾压。
技术领先者 still 是 OpenAI、Anthropic 们,但应用市场的话语权,正在发生历史性的转移。
DeepSeek们用"极致性价比"证明了一件事:
在AI时代,"够用+便宜"可能比"最强+最贵"更有生命力。
这不仅仅是一场商业竞争的结果。它意味着,未来十年,AI能力的普及速度会远超我们的预期。
而你我,正站在这个转折点上。
你觉得中国大模型能在3年内实现"能力+市场份额"双第一吗?
👇 欢迎在评论区聊聊你的看法